Sua empresa não tem um problema de IA. Tem um problema de dados.
A corrida por inteligência artificial está expondo um problema antigo dentro das empresas: dados fragmentados, definições conflitantes e contexto espalhado entre sistemas e pessoas. À medida que a IA começa a participar de decisões e executar ações, esse problema deixa de ser apenas técnico.
Sua empresa decidiu investir em inteligência artificial. Escolheu um caso de uso, contratou uma ferramenta, montou um piloto e talvez até tenha colocado um agente para conversar com alguns sistemas internos. A demonstração funcionou, todo mundo ficou animado e parecia que finalmente aquela conversa toda sobre IA estava começando a virar alguma coisa concreta.
Até que alguém resolveu fazer uma pergunta simples:
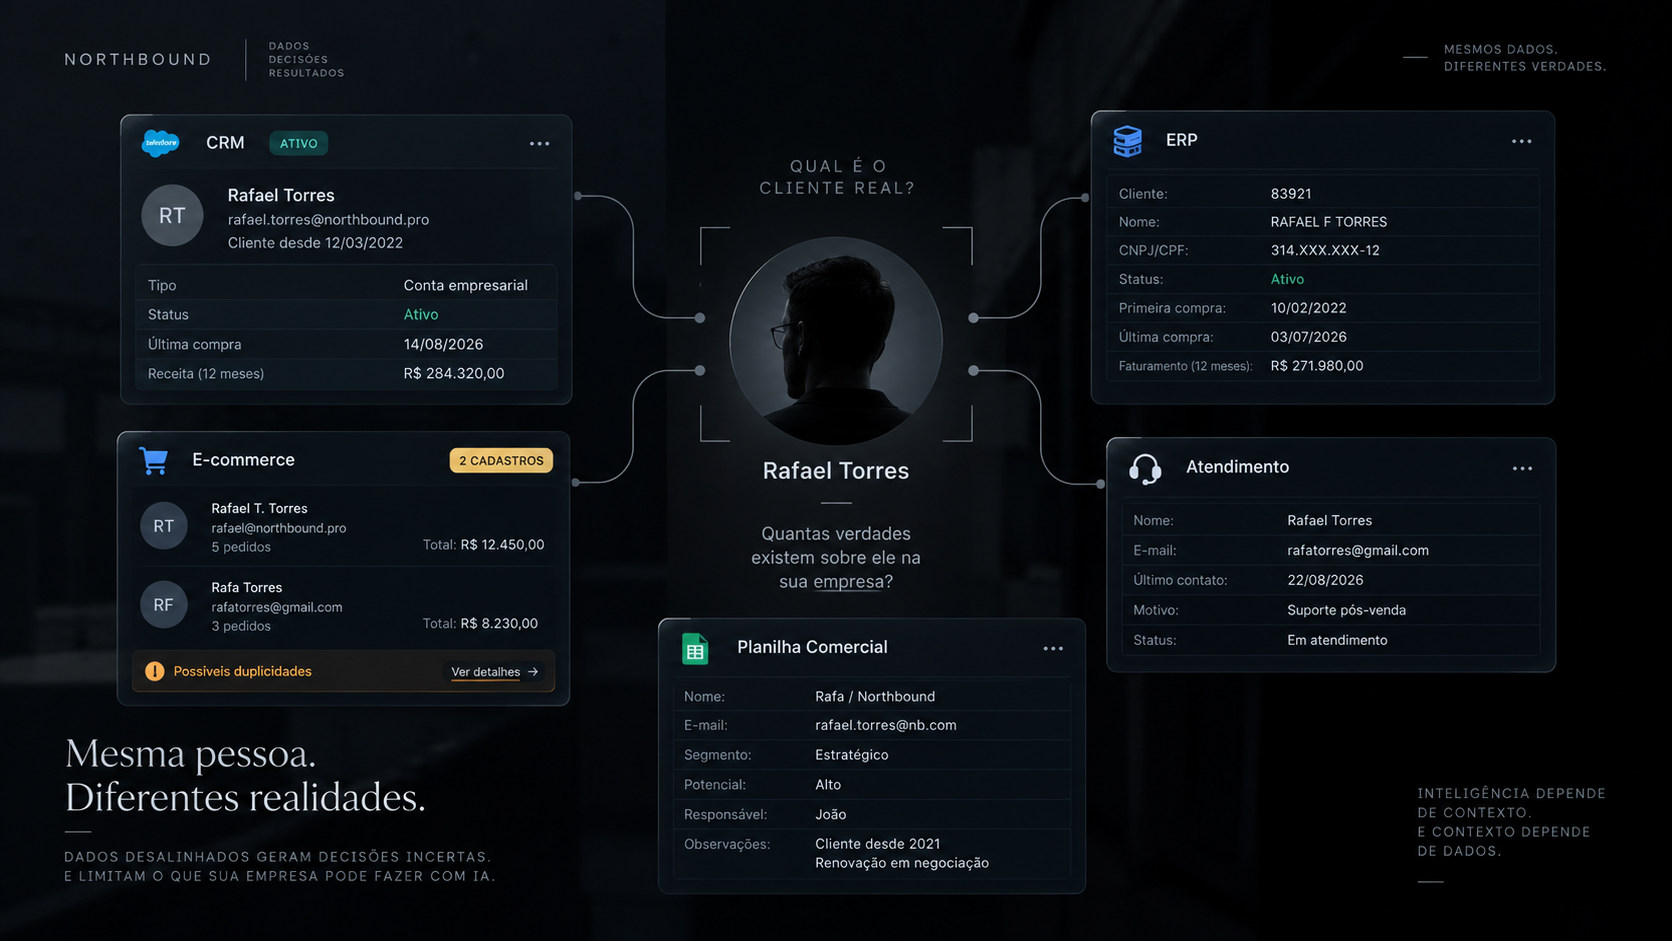
Qual é o faturamento real deste cliente?
O CRM trouxe um número, o ERP trouxe outro. No e-commerce apareceram dois cadastros para a mesma pessoa e o comercial ainda tinha uma planilha com uma informação diferente. No fim, alguém precisou chamar aquela pessoa que “conhece os dados” para entender qual daqueles números estava certo.
É uma situação banal. Quem já trabalhou dentro de uma empresa minimamente complexa provavelmente já viveu alguma versão dela. O ponto é que a IA não criou nenhum desses problemas. Eles estavam ali há anos. O que a IA está fazendo é tornar cada vez mais difícil continuar ignorando-os.
Durante anos, aprendemos a conviver com dados ruins
Boa parte das empresas que conhecemos não foi exatamente desenhada. Ela foi sendo construída ao longo do tempo, conforme novos problemas apareciam e precisavam ser resolvidos.
Um sistema entrou para cuidar das vendas, outro do financeiro. Depois vieram CRM, e-commerce, aplicativo, atendimento, BI, ferramentas de marketing. Talvez tenha acontecido uma aquisição no meio do caminho, uma troca de ERP, algumas integrações provisórias que acabaram ficando definitivas e, claro, aquelas planilhas que todo mundo usa, mas ninguém sabe exatamente quem criou.
Nada disso é necessariamente absurdo. Muitas dessas decisões provavelmente eram as decisões certas naquele momento. O problema aparece quando olhamos para o conjunto alguns anos depois.
“Cliente ativo” pode significar uma coisa para marketing e outra para financeiro. Receita pode ser pedido realizado para uma área e pedido faturado para outra. Um mesmo produto pode ter códigos diferentes dependendo do sistema e o consumidor que você acredita conhecer pode existir duas ou três vezes dentro da própria empresa.
Só que nós aprendemos a trabalhar assim.
E aprendemos porque sempre existiu uma camada invisível corrigindo boa parte dessa bagunça: as pessoas. Tem sempre alguém que sabe qual planilha está mais atualizada, qual indicador “nunca bate”, quando determinado sistema atualiza e para quem ligar quando dois números diferentes aparecem na reunião.
Durante muito tempo isso funcionou, ou pelo menos funcionou o suficiente. A empresa foi criando uma espécie de memória paralela, espalhada entre pessoas, documentos, sistemas e algumas regras que nunca foram formalizadas em lugar nenhum.
O problema começa quando queremos colocar uma máquina no meio disso e esperamos que ela entenda o negócio sozinha.
É aqui que a conversa sobre IA começa a mudar
Pedir para uma IA escrever um e-mail é relativamente simples. Se ela interpretar alguma coisa errado, alguém lê o texto, percebe o problema e corrige antes de enviar.
Agora imagine outra situação. A empresa cria um agente para identificar clientes com risco de churn e decidir quais deles deveriam receber uma oferta.
Para fazer isso direito, esse agente precisa saber quem é o cliente, conhecer seu histórico, juntar compras realizadas em canais diferentes, entender devoluções, interações recentes, margem, estoque, política comercial e talvez até o custo daquela oferta.
É nesse momento que aquela discussão sobre qual modelo utilizar começa a parecer pequena diante de uma pergunta muito mais importante: a empresa consegue entregar todo esse contexto de maneira confiável?
A McKinsey publicou em junho de 2026 uma análise sobre prontidão de dados para IA e encontrou justamente esse problema. Entre as empresas de alta performance pesquisadas, mais de dois terços apontaram dados como o principal obstáculo para habilitar inteligência artificial.
E acho que existe um detalhe particularmente interessante nessa discussão. Ter a informação armazenada não significa que ela esteja pronta para ser usada por uma inteligência artificial.
A política comercial pode estar no Drive. O contrato pode estar digitalizado. O histórico do cliente pode estar no CRM e suas compras podem estar no ERP. Ótimo. Mas qual versão da política está vigente? Como aquele contrato se relaciona com aquele cliente? Qual sistema deve prevalecer se houver uma divergência? Quando aquela informação foi atualizada? Quem responde por ela?
São perguntas que parecem muito menos interessantes do que discutir o próximo modelo de IA. Só que nenhum modelo, por melhor que seja, consegue resolver sozinho definições que a própria empresa nunca resolveu.
O piloto funcionou. E agora?
Existe outro motivo pelo qual esse problema demora para aparecer: um bom piloto consegue esconder muita coisa.
Quando fazemos uma prova de conceito, normalmente escolhemos um problema específico, selecionamos alguns documentos, limpamos uma base, definimos um processo e acompanhamos o comportamento de perto. Se alguma coisa estiver errada, corrigimos. Se existir uma exceção, tratamos. Faz parte do processo e é justamente para isso que um piloto existe.
Só que existe uma diferença importante entre provar que a tecnologia consegue fazer alguma coisa e provar que a empresa consegue fazer aquilo em escala.
Quando a IA sai desse ambiente mais controlado, ela encontra a empresa de verdade. Encontra dados duplicados, documentos antigos, sistemas que não conversam, permissões conflitantes, campos que ninguém preenche, conceitos diferentes para a mesma coisa e informações importantes que só existem porque alguém trabalha ali há quinze anos e sabe como aquilo funciona.
É justamente nessa passagem que várias pesquisas recentes começam a mostrar um gap interessante.
Em outro estudo publicado neste ano, a McKinsey aponta que quase dois terços das empresas já experimentaram agentes, mas menos de 10% conseguiram escalá-los até a geração de valor tangível. Entre as barreiras apontadas, limitações relacionadas aos dados aparecem novamente com enorme peso.
Uma pesquisa da IDC divulgada pela SAS, feita com 2.699 decisores em 28 países, encontrou apenas 17,5% das organizações afirmando possuir uma infraestrutura de dados plenamente otimizada para as novas exigências da IA. O mesmo estudo encontrou uma associação bastante relevante entre fundações de dados mais maduras e expectativa de retorno dos projetos de inteligência artificial.
São pesquisas diferentes, com metodologias e interesses diferentes, então não acho correto simplesmente empilhar os números e tratá-los como uma verdade absoluta. Mas existe um sinal comum entre elas que merece atenção: estamos ficando muito bons em demonstrar o que a IA consegue fazer e ainda temos bastante trabalho para conseguir colocar isso para funcionar dentro da complexidade de uma empresa real.
Talvez estejamos começando a conversa pelo modelo
Quando uma empresa começa a discutir IA, é natural que algumas perguntas apareçam primeiro. Qual LLM vamos usar? OpenAI ou Anthropic? Precisamos de RAG? Vale construir agentes? Qual plataforma integra melhor com nossos sistemas?
Eu também faço essas perguntas. Elas importam.
Só não tenho certeza de que deveriam ser sempre as primeiras.
Os modelos estão evoluindo muito rápido e, ao mesmo tempo, ficando mais baratos e acessíveis. Uma capacidade que hoje parece extraordinária provavelmente estará disponível em várias plataformas daqui a algum tempo. Escolher bem a tecnologia continua sendo importante, claro, mas é difícil imaginar que essa escolha, sozinha, sustente uma vantagem competitiva por muito tempo.
Agora pense no que existe dentro da empresa.
Seu histórico de clientes, seus produtos, comportamento de compra, relações comerciais, decisões anteriores, estrutura de custos, regras, exceções, conhecimento operacional e todas as relações que foram sendo construídas entre essas coisas ao longo dos anos.
Nenhum modelo público chega sabendo disso.
Na prática, existe uma memória do negócio que pertence à própria empresa. Parte dela está nos bancos de dados, parte está nos documentos, outra parte nos sistemas e, como vimos antes, uma quantidade enorme ainda está na cabeça das pessoas.
Talvez a discussão mais interessante não seja apenas sobre qual inteligência vamos colocar dentro da empresa, mas sobre quanto da empresa essa inteligência será capaz de compreender.
E isso não se resolve simplesmente colocando tudo em um Data Lake
Também existe um risco de levar essa discussão para o outro extremo e concluir que a resposta é armazenar absolutamente tudo.
Não é.
Uma empresa pode ter bilhões de registros e continuar entendendo muito pouco sobre si mesma. Se ninguém sabe exatamente o que um dado significa, de onde ele veio, quando foi atualizado, quem responde por ele ou qual fonte deve prevalecer em uma divergência, aumentar o volume não resolve o problema.
A questão fica ainda mais importante quando começamos a falar de agentes.
Em agosto deste ano, a Gartner propôs uma evolução interessante no conceito de AI-ready data. À medida que a IA começa não apenas a responder perguntas, mas também a consultar sistemas e executar ações, as empresas precisam pensar em agent-ready data: dados preparados para serem consumidos por sistemas com maior autonomia.
A BCG chegou a uma preocupação semelhante ao discutir risco em IA agêntica. Qualidade, linhagem, proveniência e responsabilidade sobre os dados ganham outra dimensão quando um sistema consegue agir sobre uma informação antes que alguém tenha tempo de perceber que ela estava errada.
Isso ajuda a entender por que um problema antigo começa a ficar mais urgente agora.
Se um número errado aparece em um dashboard durante uma reunião, alguém pode levantar a mão e dizer: “esse número não está certo”. A discussão para, alguém verifica e a vida segue.
Se um agente utiliza a mesma definição errada para tomar centenas de decisões antes que alguém perceba, o problema ganhou outra escala.
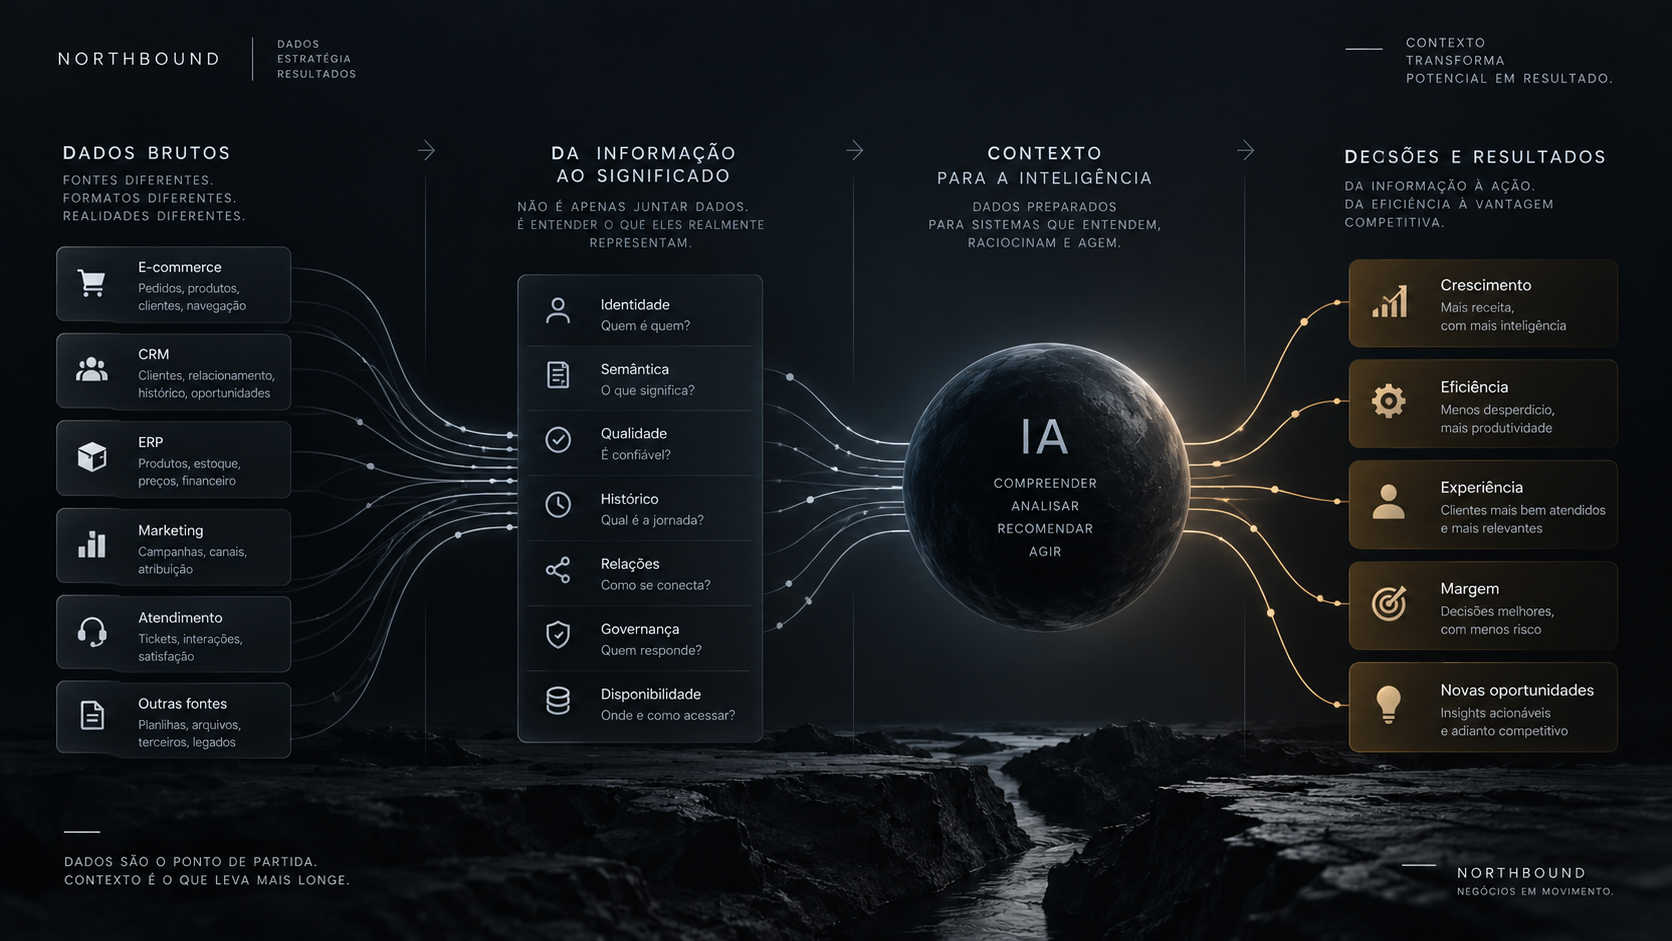
Por isso, quando falamos em preparar dados para IA, talvez a melhor imagem não seja a de um grande repositório. É a construção de contexto.
A inteligência precisa conseguir entender quem é quem, o que cada informação significa, como diferentes entidades se relacionam, o que aconteceu antes, quais fontes merecem confiança, quais regras precisam ser respeitadas e quais exceções fazem parte daquele negócio.
Aí a conversa deixa de ser simplesmente sobre dados e começa a ser sobre conhecimento da empresa.
O ativo talvez esteja justamente aí
Existe uma coisa que me chama bastante atenção em toda essa corrida.
OpenAI, Anthropic, Google e outros fornecedores vão continuar lançando modelos melhores. As capacidades vão mudar, os custos vão cair, algumas tecnologias que hoje parecem sofisticadas vão virar commodities e provavelmente vamos trocar várias das ferramentas que estamos usando agora.
Mas o histórico da sua empresa não é commodity.
A relação construída com seus clientes não é commodity. A maneira como seus produtos, operações, decisões e resultados se conectam também não. Esse contexto foi acumulado ao longo de anos e nenhum fornecedor de IA possui isso por padrão.
É por isso que acredito que uma parte relevante da vantagem competitiva criada com IA não estará necessariamente no modelo escolhido, mas na capacidade de uma organização fazer esse modelo compreender o negócio melhor do que qualquer alternativa genérica conseguiria.
E talvez seja essa a parte menos glamourosa dessa transformação.
Organizar identidade, integrar fontes, definir conceitos, melhorar qualidade, preservar histórico, estabelecer responsabilidades e construir relações entre informações não rende a mesma demonstração impressionante que um agente executando uma tarefa sozinho.
Só que provavelmente é esse trabalho que vai permitir que aquele agente funcione quando a demonstração acabar.
No fim, talvez seja essa a diferença entre uma empresa que simplesmente usa IA e outra que realmente consegue operar com ela. Não quantas ferramentas ela contratou ou quantos pilotos colocou no ar, mas o quanto consegue entregar contexto confiável para que esses sistemas participem do negócio de verdade.
Por isso, se sua empresa está pensando no próximo projeto de inteligência artificial, talvez valha fazer uma pergunta antes de escolher o modelo.
O que exatamente ela vai encontrar quando olhar para os seus dados?
Fontes e referências
McKinsey & Company
AI data readiness: The key to scaling impact
junho de 2026
McKinsey & Company
Building the foundations for agentic AI at scale
abril de 2026
Gartner
AI-Ready Data Needs to Expand to Agent-Ready Data
agosto de 2026
BCG
Managing Data Risk in the Age of Agentic AI
junho de 2026
SAS / IDC
2026 Data and AI Impact Report
2026
Alguns problemas começam em tecnologia. Outros apenas aparecem nela.